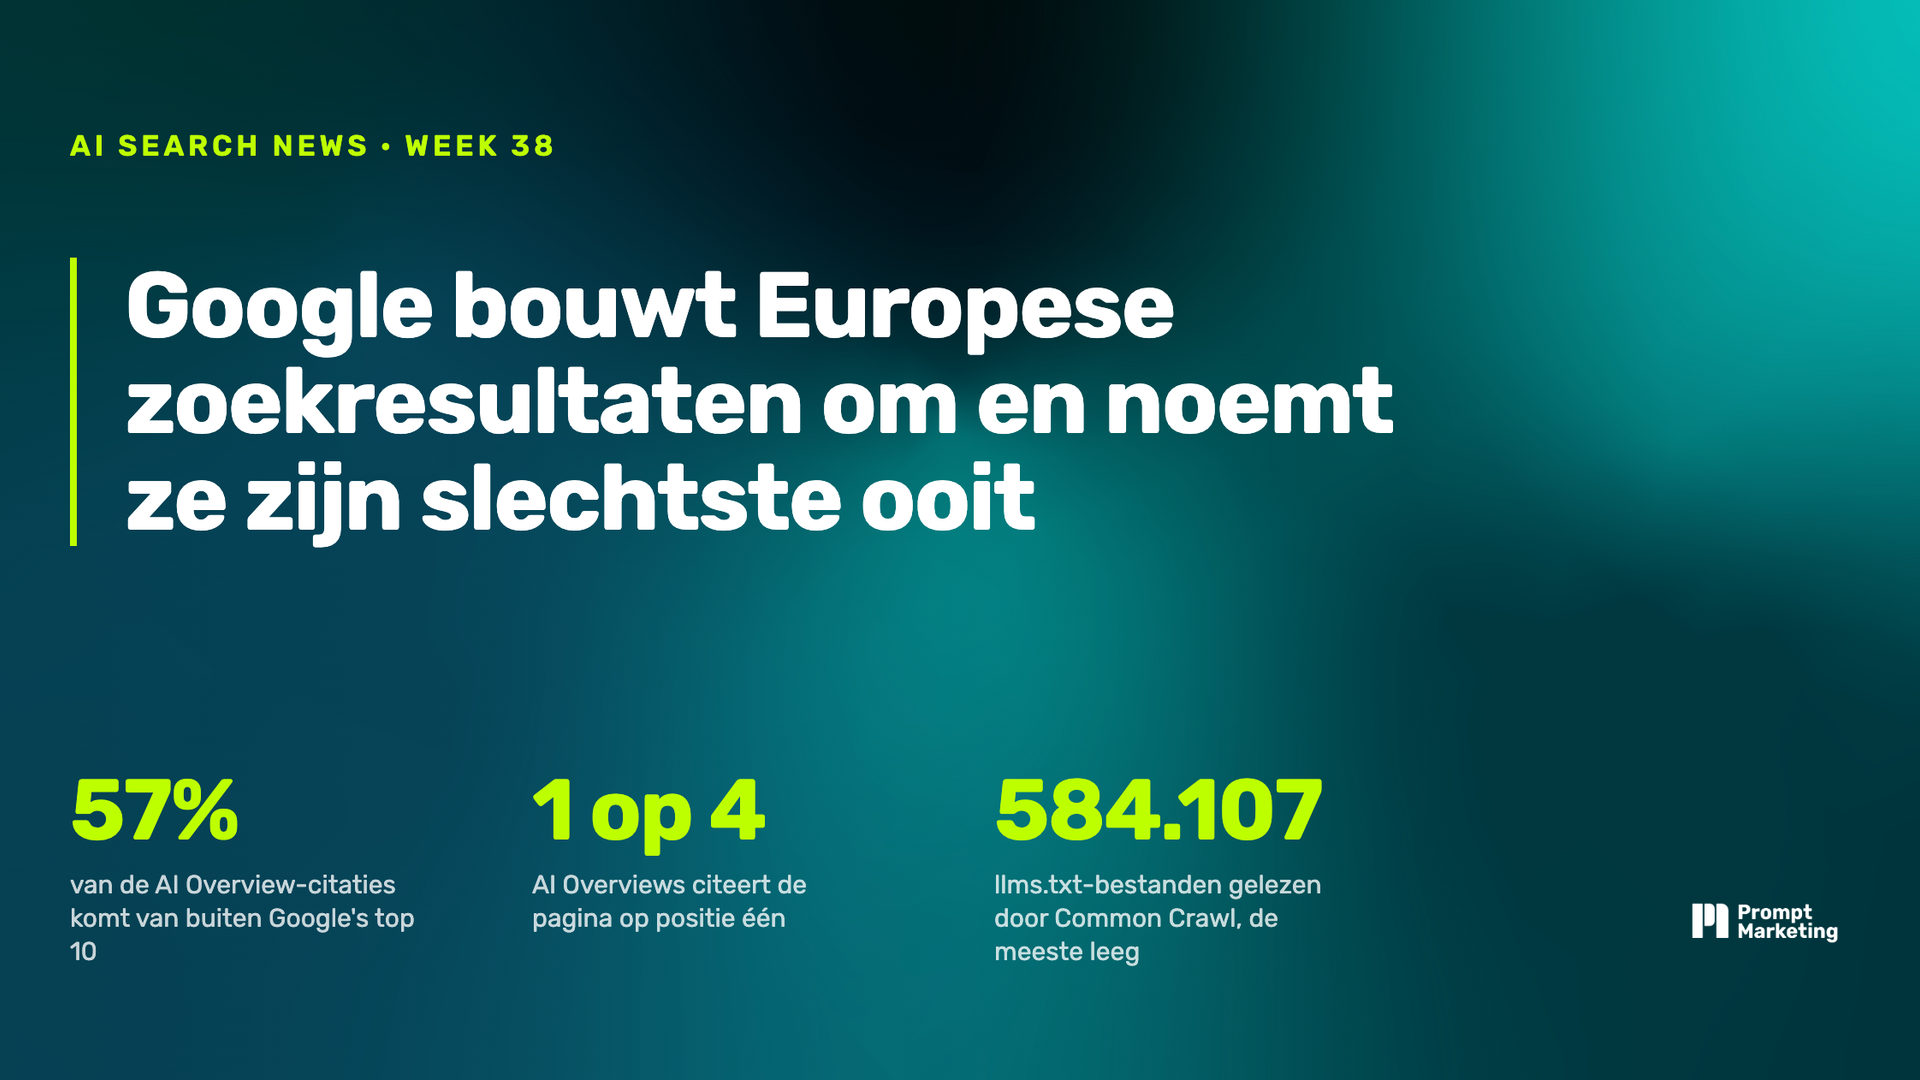
Deze week in AI Search News: Google bouwde zijn Europese resultaten om onder de DMA en noemt het de grootste kwaliteitsdaling uit zijn geschiedenis, Conductor vond dat 57% van de AI Overview-citaties van buiten Google's top 10 komt, Profound liet zien dat dezelfde vraag andere merken oplevert afhankelijk van wie hem stelt, Common Crawl las 584.107 llms.txt-bestanden, en Apple bevestigde dat zijn trainingscrawler niets met de search van Siri te maken heeft.
Google bouwde zijn Europese resultaten om onder de DMA, en noemt het de grootste kwaliteitsdaling uit zijn geschiedenis
Google rolde op 8 september een nieuwe resultatenpagina uit voor commerciële zoekopdrachten in de Europese Economische Ruimte, en Search Engine Journal beschrijft de indeling. Voor hotels, vluchten, lange trein- en busreizen en producten staat nu een aggregator unit bovenaan. Die toont één goedgekeurde vergelijkingsdienst standaard uitgeklapt, met de andere goedgekeurde diensten achter een dropdown, en er verschijnt maar één zo'n unit per zoekopdracht. Daarnaast staat een supplier unit voor het hotel, de luchtvaartmaatschappij of de winkel zelf. De supplier unit heeft geen feed nodig, alleen wat Google al kan crawlen, en verschijnt alleen wanneer er ook een aggregator unit staat. De documentatie van Google noemt de formulieren voor vergelijkingsdiensten die mee willen doen. Reuters beschrijft de pagina als één gespecialiseerde dienst bovenaan, twee eronder met minder detail, en een carrousel zonder live prijzen.

De aanleiding was de boete van 460 miljoen euro in juli voor zelfbevoordeling, met een deadline van 60 dagen, zo meldt Quartz. Google zei tegen Reuters dat de wijzigingen "mark the largest reduction in quality of service at the world's most popular internet search engine in its 29-year search history", en Search Engine Land heeft de verklaring. Nick Fox, SVP Knowledge and Information bij Google, zegt dat de wijzigingen "degrade the user experience for Europeans" doordat ze tussenpersonen bevoordelen ten koste van lokale bedrijven. Google voegt toe dat de eerdere DMA-maatregelen de gratis directe boekingsverwijzingen naar Europese bedrijven al met 30% hadden verlaagd, en dat deze ronde die daling verdiept. Gebruikers buiten de EU merken er niets van. De boekingswidgets dragen nu ook een disclaimer dat de getoonde prijzen zijn aangepast "based on factors such as your device type", gemeld door Search Engine Roundtable op 7 september. Een Nederlandse zoekopdracht naar hotels in Parijs toonde op 14 september nog de oudere carrousel "Sites voor plaatsen" boven een hotellijst met prijzen, dus de nieuwe units staan nog niet op elke zoekopdracht.
Onze kijk erop: die 30% is het cijfer van Google zelf, gepubliceerd midden in een persgevecht met de Commissie, dus neem het met een korrel zout. Twee dingen staan vast. Ben je een hotel, luchtvaartmaatschappij, vervoerder of winkel in Europa, dan is de supplier unit een gratis plek die op gecrawlde data draait. Controleer deze week dus of je boekings- en productpagina's crawlbaar zijn en prijs en beschikbaarheid in structured data dragen. En niets in de documentatie raakt AI Overviews of AI Mode. De pagina onder het AI-antwoord werd net slechter voor directe bedrijven, en het AI-antwoord erboven veranderde niet. Daarmee verschuift meer van de beslissing naar het antwoord, en dat is het deel dat je nog kunt verdienen.
57% van de AI Overview-citaties komt van buiten Google's top 10
Conductor telde 167.867.680 AI Overview-citaties op Amerikaanse Google-zoekopdrachten tussen 15 juni en 15 augustus, over elke sector en zonder steekproef van zoekwoorden, en publiceerde de verdeling op 10 september. Pagina's in de organische top 10 leverden 43% van alle citaties. Pagina's buiten de top 10 leverden 57%. Posities één tot en met drie leverden samen ongeveer 20%, en positie één alleen 8,5%. Per positie gelezen: de pagina op nummer één wordt geciteerd in 24,9% van de AI Overviews op zijn zoekopdracht, nummer twee in 21,1%, nummer drie in 17,9% en nummer tien in 10,2%. Conductor noemt het verband een correlatie en laat het daarbij.

Onze kijk erop: lees die 57% met de noemer erbij. De top 10 bevat tien pagina's en alles daaronder bevat miljoenen, en die tien pakken nog altijd 43% van alle citaties, dus per pagina wordt een top 10-resultaat veel vaker geciteerd dan wat eronder staat. Het cijfer dat telt voor een merk is het andere. De pagina op positie één wordt geciteerd in één AI Overview op de vier. Drie van de vier keer schrijft Google het antwoord van ergens anders, en daar kan een pagina binnenkomen die je nooit hebt laten ranken. Rank tracking ziet geen van beide kanten, het punt dat we in januari maakten, en het AI performance report in Search Console geeft elke site nu het aantal citaties per pagina om naast de ranking te leggen.
Dezelfde vraag, andere merken: het antwoord verandert met wie hem stelt
Profound draaide tussen 11 en 24 augustus 71.147 antwoorden door ChatGPT, Claude en Gemini, op prompts over creditcards, kleding en meubels, en publiceerde de resultaten op 9 september. Elke prompt kreeg een persona-regel vooraf, zoals "I am in my 30s", met variatie in geslacht, leeftijd, inkomen en beroep. Dezelfde persona die twee keer vroeg, kreeg 40% overlap in merken en 34% overlap in geciteerde domeinen. Twee verschillende persona's kregen 25% en 20%. Inkomen bewoog het meest. Een persona met laag inkomen kreeg 5,8 merkvermeldingen en 4,1 citaties per antwoord, een persona met hoog inkomen 7,5 en 4,8. De kledingmerken voor de persona met laag inkomen zaten op 8 tot 24 dollar, met Poshmark en Depop ertussen. De persona met hoog inkomen kreeg The Row, Brunello Cucinelli, Loro Piana en Hermès op 140 tot 1.650 dollar. Op inkomen alleen deelden twee verschillende persona's 17% van hun merken, tegen 40% voor dezelfde persona die twee keer vroeg. In de kledingantwoorden van Gemini zag de persona met hoog inkomen sites van merken zelf 24 punten vaker geciteerd dan de persona met laag inkomen, en earned media 17 punten minder. Kledingantwoorden voor een persona van in de vijftig bevatten in ChatGPT en Claude 39 punten vaker het woord "women".

Onze kijk erop: de tracker waar je voor betaalt stelt zijn prompts zonder enige persona, en dat is een klant die niet bestaat. De methode van Profound is een tekst vooraf, en het geheugen van ChatGPT doet stilletjes hetzelfde voor elke ingelogde gebruiker, uit maanden chatgeschiedenis. Je visibility score is dus één plak uit een verdeling, en welke plak hangt af van wie je koper is. Ook de bronnen waarin je moet staan hangen van de koper af. Bij de prompt met hoog inkomen leest het model de site van het merk zelf. Bij de prompt met laag inkomen leest het wat anderen schreven. Daarom scoren wij twee assen op onze Visibility en Representation matrix: een merk kan Category Leader zijn voor de persona met hoog inkomen en Invisible Brand voor de persona met laag inkomen op dezelfde vraag, en Misrepresented Brand voor een derde. Eén gemiddeld cijfer verbergt alle drie.
Common Crawl las 584.107 llms.txt-bestanden, en de meeste doen niets
Common Crawl analyseerde elk llms.txt-bestand in zijn index, en Search Engine Journal heeft de cijfers van 8 september. 68% van de 584.107 bestanden kwam uit een plugin of template, en Wix alleen al leverde 41%. 22% bevatte geen enkele link. 49% had de volledige structuur van een titel, een samenvatting en linksecties, en 32% beschreef elke link. 1.570 bestanden noemden specifieke crawlers en 32 probeerden CCBot te weigeren, wat het format niet kan afdwingen, en van 31 van die sites blokkeerde er geen enkele CCBot in robots.txt. Van de sites die Common Crawl kon bereiken had 11% een llms.txt. Tien bestanden voldeden aan een strenge test op prompt injection, vier daarvan echt.

Onze kijk erop: een llms.txt is een leeslijst voor een model, en een crawlerregel erin is een wens. Houd toegangsregels in robots.txt, waar ze gelezen worden, en gebruik de llms.txt voor wat hij kan: een model wijzen op de tien pagina's die je producten en je verschillen in gewone taal beschrijven. Een gegenereerd bestand zonder links, en dat is er een op de vijf, vertelt een model niets. En verwacht er hoe dan ook weinig van. De crawldata van Otterly, deze week gedeeld via een podcast, laat vrijwel geen crawleractiviteit op llms.txt zien terwijl sitemaps voortdurend worden opgehaald, en dat klopt met wat wij in klantlogs zien.
Apple bevestigt dat Applebot-Extended niets met search te maken heeft, terwijl Siri 2,5 miljard verzoeken per dag haalt
Apple voegde op 4 september één regel toe aan zijn Applebot-documentatie: "Site rules for Applebot-Extended are not considered in ranking for Search", aldus Search Engine Roundtable. Applebot-Extended is de schakelaar die je content buiten de modeltraining van Apple houdt. Hem blokkeren raakt de resultaten van Siri, Spotlight en Safari niet. Op zijn event van 9 september zei Apple ook dat Siri 2,5 miljard verzoeken per dag verwerkt.

Vandaag verschijnt iOS 27 met Siri AI, dat webvragen beantwoordt met citaties uit Apple's eigen index, en wij publiceerden wat we ervan verwachten. De index wordt gevuld door Applebot, actief sinds 2015, die nu search, training en het genereren van antwoorden vanuit één crawler bedient. Begin september telden wij 1.905 Applebot-verzoeken vanaf 664 Apple-adressen over de markten die wij volgen. Applebot-Extended crawlt zelf niets. En als je robots.txt geen regels voor Applebot bevat, volgt Applebot je regels voor Googlebot.
Onze kijk erop: drie controles, tien minuten. Open je robots.txt en zoek naar een disallow voor Googlebot, want die geldt nu ook voor de crawler van Siri tenzij je Applebot eigen regels geeft. Beslis apart over Applebot-Extended, als een trainingsvraag zonder kosten voor je zichtbaarheid. En haal de Applebot-regels van de afgelopen maand uit je serverlog, want dat is de enige plek waar je de belangstelling van Siri voor je pagina's ziet totdat Apple een rapport levert. Wij verwachten dat lokale en feitelijke vragen als eerste naar Siri verhuizen en dat shopping bij Google blijft, dus een restaurant, een kliniek of een winkel met een adres heeft het meest te controleren.
Ook opgemerkt
• John Mueller zei op Reddit dat een positie binnen een AI Overview "is hard to do in a way that makes it useful", dus Search Console volgt de AI Overview als één blok, en Search Engine Roundtable heeft de citaten van 10 september. Een impressie telt ook als de gebruiker nooit tot jouw link scrolt. In dezelfde week mat AlsoAsked dat AI Overviews 97% van de People Also Ask-vakken beantwoorden, tegen 86% in augustus en ongeveer 12% veertien maanden geleden, aldus Search Engine Roundtable, en Google begon een smaller citatiepaneel te testen naast de AI Overview.
• Een working paper van de University of Washington schat dat AI Overviews de zoekverwijzingen naar de Engelse Wikipedia met ongeveer 5% verlaagden ten opzichte van de Duitse en Franse edities, zo'n 100 miljoen verwijzingen per maand, en Search Engine Journal beschreef het op 11 september. Louis Dreyfus, CEO van Le Monde, zegt dat zijn publiek zeven weken na de lancering van AI Overviews in Frankrijk niet is gekrompen, met de app op 36% van het groepsverkeer, met de kanttekeningen hier.
• Semrush onderzocht 458 zoekwoorden en AI-vermeldingen in de maakindustrie van januari tot juli en vond dat de meest genoemde merken, 3M, John Deere en Boeing, nauwelijks overlappen met de meest geciteerde bronnen, waar alleen Vevor en Grainger op beide lijsten staan, en dat AI search 0,48% van de sessies naar productiesites is, in de studie van 8 september.
• Het aandeel van Perplexity in chatbotverwijzingen wereldwijd daalde volgens StatCounter van 7,91% in juni naar 4,31% in augustus, terwijl Gemini van 7,94% naar 10,9% steeg, en Search Engine Journal vraagt of het nog in je tracking thuishoort.
• Het AI Performance-rapport van Google Merchant Center kreeg drie secties erbij, AI Search intent, AI Search terms en AI attributes, met suggesties om populaire termen en ontbrekende attributen toe te voegen aan producten die in AI-zoekopdrachten verschijnen, gespot door Brodie Clark.
• AI Mode test gepagineerde vervolgantwoorden met een skip-knop, en Google DeepMind publiceerde een test van Autoregressive Ranking, één model dat retrieval en ranking moet vervangen, samengevat door Search Engine Journal.
Dat was de week. Wil je weten wat dit betekent voor je eigen AI visibility, dan staat onze deur open.